Qwen3.8-Max-0902 вышла в лидеры Code Arena WebDev с минимальным отрывом
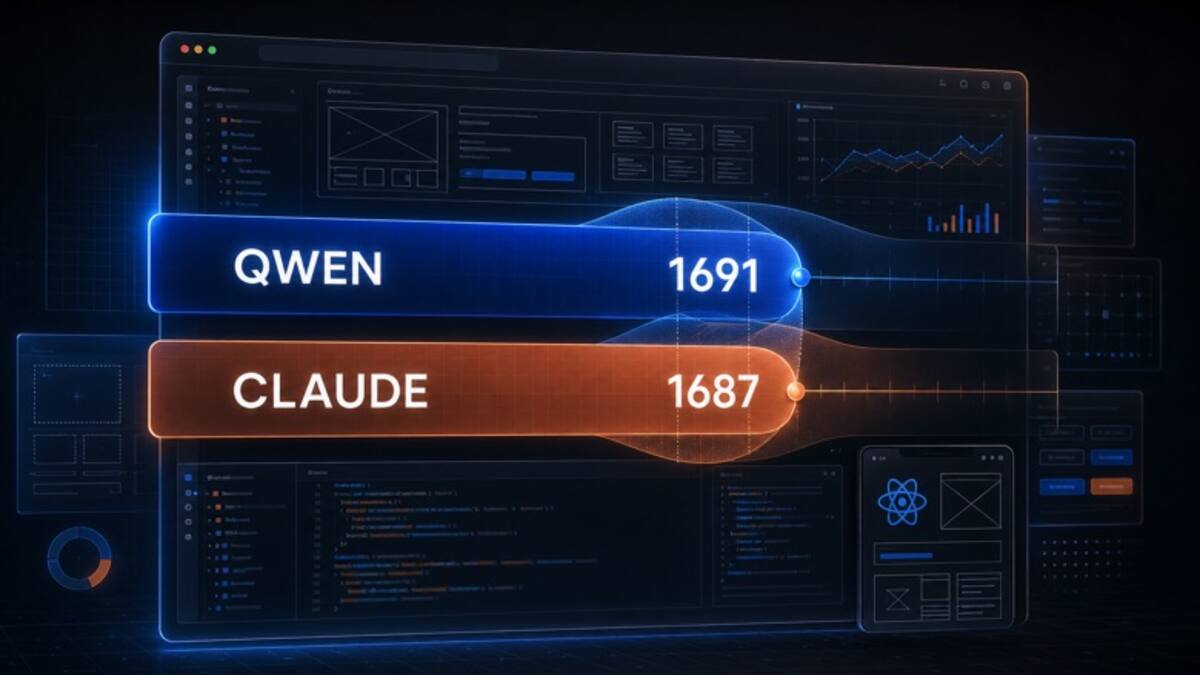
Модель Alibaba Qwen3.8-Max-0902 заняла первое место в общем зачёте бенчмарка Code Arena WebDev, набрав 1691 очко и опередив Claude Opus 5 Max на три пункта. Модель улучшили за счёт дообучения с подкреплением. Результат пока предварительный: голосов у новой модели значительно меньше, а доверительные интервалы лидеров пересекаются, поэтому преимущество не является статистически значимым.
2 сентября модель Qwen3.8-Max-0902 от Alibaba вышла на первое место в общем зачёте бенчмарка для веб-разработки Code Arena WebDev. На момент подведения промежуточного результата она набрала 1691 очко и опережала предыдущего лидера, Claude Opus 5 Max от Anthropic, всего на три пункта.
Разработчик улучшил модель без выпуска новой версии: Alibaba провела дополнительное обучение с подкреплением, сделав упор на программирование и долгосрочную работу агентов, после чего представила версию Qwen3.8-Max-0902.
Несмотря на красивую цифру в турнирной таблице, у результата есть важные оговорки. Статус Qwen помечен как предварительный, а число голосов, на основе которых посчитан её балл, в несколько раз меньше, чем у конкурентов. При этом доверительные интервалы двух моделей сильно перекрываются, то есть разница в три очка находится в пределах статистической погрешности. Пока готовился этот материал, количество голосов и размер отрыва уже успели измениться.
Статистическая значимость результата определяется не только набранными очками, но и доверительным интервалом — разбросом значений, в котором с заданной вероятностью находится истинный уровень модели. Чем меньше голосов, тем шире интервал и тем менее надёжно текущее место в рейтинге. По этой причине первое место с пересекающимися интервалами стоит читать не как победу, а как сигнал о примерном равенстве сил лидеров.
Как устроен рейтинг Code Arena
Code Arena — это платформа для сравнительного тестирования моделей в веб-разработке. Пользователям показывают пары решений, сгенерированных разными моделями на один и тот же запрос, и просят выбрать лучшее по визуальному качеству, соответствию требованиям и скорости. Голосование ведётся по принципу турнира: каждая модель «сражается» с другими, а итоговый балл (Elo) пересчитывается после каждого нового раунда голосов.
Такой подход даёт оценку относительного качества моделей не по синтетическим тестам, а на основе мнения живых пользователей. Однако у Elo-рейтинга есть особенность: чем меньше пар провела модель, тем нестабильнее её позиция. Новый лидер с малым числом голосов может как закрепиться на вершине, так и откатиться вниз после следующей серии сравнений.
Что это значит на практике
Для разработчика, выбирающего инструмент, единственное лидирующее место в рейтинге с пересекающимися интервалами — не повод менять рабочую модель. Более информативным сигналом будет устойчивое лидерство на протяжении нескольких недель и значительное число голосов.
Рейтинг Code Arena отражает лишь один срез возможностей модели — генерацию кода для веб-интерфейсов. Для оценки всей модели целиком Alibaba публикует собственные тесты и сравнительные таблицы, но независимые бенчмарки вроде этого обычно считаются более объективным источником. Сам обзор по методике платформы автор исходного материала не проводил, ограничившись разбором открытых данных.
Хабр ИИ · права на исходный материал принадлежат автору.
Материал носит информационный характер и не является индивидуальной инвестиционной рекомендацией. Операции с криптовалютами связаны с риском полной потери вложенных средств. Подробнее — «Отказ от ответственности».
Разборы событий, итоги дня и то, что двигает рынок. Без сигналов и обещаний — только факты и что они значат.
Читать в Telegram →По теме
- ▪Microsoft сделает Copilot средством диагностики неполадок Windows3DNews · 18 ноября
- ▪Google открыла бесплатный доступ к ИИ-агенту Gemini Tasks в шести странахiXBT · 18 ноября
- ▪OpenAI выпустила GPT-6.2 Astra и Sol: Astra в API подешевела на 20%Tproger · 17 ноября
- ▪Сбер оценил выручку ОМК в 2,569 трлн рублей до 2036 годаiXBT · 17 ноября