ИИ-модель Brain-IT восстанавливает увиденные изображения по данным фМРТ
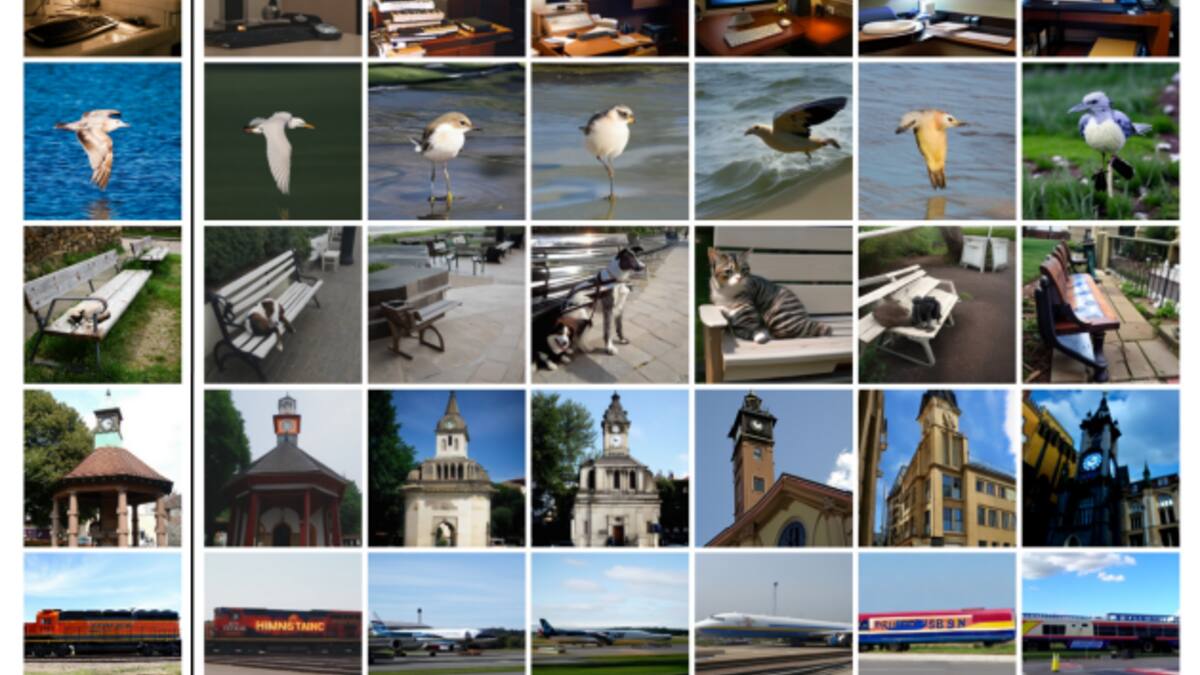
Учёные представили модель Brain-IT, которая реконструирует увиденные человеком картинки по данным функциональной МРТ. Она разделяет смысл изображения и его структуру, что повышает точность, и показывает результаты при 15 минутах записи нового участника.
Исследователи разработали ИИ-модель Brain-IT, восстанавливающую изображения, которые человек видел, по данным функциональной МРТ (fMRI). Ключевое отличие от прежних методов — в разделении двух типов информации: смысла картинки и её низкоуровневой структуры. Раньше диффузионная модель могла верно определить объекты, но ошибаться в их расположении и цветах.
Как устроена модель
Сначала активность мозга сжимают: примерно 40 тысяч вокселей — объёмных элементов данных fMRI — сводят к 128 функциональным кластерам, объединяющим воксели со схожими характеристиками. Каждый кластер превращается в Brain Token, с которым работает Transformer.
Из токенов извлекаются два набора визуальных признаков. Первый описывает смысл изображения и подаётся на вход диффузионной модели, определяя, какие объекты и сцены должны получиться. Второй несёт низкоуровневую информацию — общую структуру и расположение элементов; по нему система восстанавливает грубый вариант картинки, который становится начальной точкой для диффузионной генерации. По данным авторов, объединение двух веток даёт более точное соответствие исходному изображению, чем использование каждой по отдельности.
Результаты на Natural Scenes Dataset
Модель проверяли на Natural Scenes Dataset — наборе данных fMRI восьми человек, которым показывали разные фотографии. В основном сравнении Brain-IT превзошла предыдущие методы по 7 из 8 метрик. Структурное сходство SSIM составило 0,486 против 0,431 у лучшего предыдущего результата MindEye2, корреляция пикселей выросла до 0,386 против 0,322.
Заметный результат получен при работе с данными нового человека: авторы отмечают, что качество сопоставимо с показателями методов, обучавшихся на полном наборе из 40 часов данных, при 1 часе fMRI у Brain-IT. Качественные реконструкции удалось получить и при 30 и 15 минутах записи нового участника — исследователи называют это первым, по их данным, случаем такого качества при 15-минутной записи.
При этом речь не идёт о буквальном чтении картинки из мозга за 15 минут: качество остаётся ограниченным, отдельные объекты и детали могут восстанавливаться неверно. Brain-IT не превращает fMRI в точную видеозапись активности мозга — задача уже: извлечь из ограниченного и шумного сигнала достаточно информации, чтобы отдельно восстановить содержание изображения и его структуру, а затем объединить их генеративной моделью.
Анализ механизма внимания показал специализацию отдельных токенов: разные токены систематически влияли на разные области предсказываемого изображения, а некоторые были преимущественно связаны с семантически значимыми зонами — лицами, конечностями, текстом. По словам авторов, это пока свойство работы модели, а не готовая новая карта зрительной коры.
iXBT · права на исходный материал принадлежат автору.
Материал носит информационный характер и не является индивидуальной инвестиционной рекомендацией. Операции с криптовалютами связаны с риском полной потери вложенных средств. Подробнее — «Отказ от ответственности».
Разборы событий, итоги дня и то, что двигает рынок. Без сигналов и обещаний — только факты и что они значат.
Читать в Telegram →По теме
- ▪Специалист по безопасности Дэвид Робинсон ушёл из OpenAI и раскритиковал её культуруiXBT · 4 октября
- ▪Трамп назначил Джей Клейтона куратором развития ИИ в США3DNews · 4 октября
- ▪Генпрокурор Калифорнии вручил OpenAI повестку о безопасности ИИ-моделейiXBT · 4 октября
- ▪Toshiba вложит $380 млн в удвоение выпуска HDD для ИИ-дата-центровiXBT · 4 октября