Google открыла Gemini 4 Carbon только специалистам по киберзащите
28 октября 2026 года Google DeepMind представила Gemini 4 Carbon — модель, которую компания называет сильнейшей в кибербезопасности и длительных агентных задачах. Первыми доступ получат отобранные эксперты по защите и партнёры программы Fairwind, дата открытия для разработчиков и бизнеса не названа. Вводная цена совпадает с Argon: $2 ≈ 5,89 BYN за миллион входных и $10 ≈ 29,46 BYN за миллион выходных токенов.
28 октября 2026 года Google DeepMind представила Gemini 4 Carbon. Модель вышла спустя две недели после того, как компания открыла публичный доступ к Gemini 4 Argon. Новинку в Google описывают как самую сильную свою разработку, делая упор на двух направлениях — кибербезопасность и длительные агентные задачи.
Доступ откроют не сразу и не всем. На текущей неделе модель получат отдельные специалисты по киберзащите, дальше круг расширят на доверенных партнёров программы Fairwind. Разработчикам, компаниям и обычным пользователям Carbon пообещали «как можно скорее», но срок не назвали: компания собирает отзывы и дорабатывает защитные ограничения. Собственный подход к запуску в Google называют осторожным; компания также участвует в добровольной программе правительства США по тестированию моделей до релиза.
Цена и характеристики
Тарифы на старте те же, что у Argon: $2 ≈ 5,89 BYN за миллион входных токенов и $10 ≈ 29,46 BYN за миллион выходных. После вводного периода — $4 ≈ 11,78 BYN и $20 ≈ 58,92 BYN соответственно, кэшированный вход обойдётся в $0,10 и $0,20. Когда именно закончится вводный период для Carbon, Google не сообщила; у Argon такая цена действует до 30 ноября.
Данных о контекстном окне, лимитах API и тарифах подписки Google AI в анонсе нет. По карточке модели на сайте Artificial Analysis контекст составляет 1 млн токенов: на входе Carbon принимает текст, изображения, речь и видео, на выходе отдаёт текст.
Первое место в индексе Artificial Analysis
Carbon возглавила Artificial Analysis Intelligence Index v5.0 с 59 баллами — первая из 52 моделей; результат независимо подтверждён на сайте Artificial Analysis. Следом идут Claude Opus 5.5 с 58 баллами и GPT-6 Astra с 57.
За первое место модель платит объёмом рассуждений: на прохождение индекса у неё ушло 200 млн выходных токенов при медиане 64 млн — 49-е место из 51 по многословности. Одна задача индекса стоила $7,76 ≈ 22,86 BYN по цене после вводного периода. У Claude Opus 5.5 в режиме max, по данным Artificial Analysis, выходит $10,04 ≈ 29,58 BYN за задачу, у GPT-6 Astra — $6,24.
Бенчмарки: лидерство в 15 строках из 17
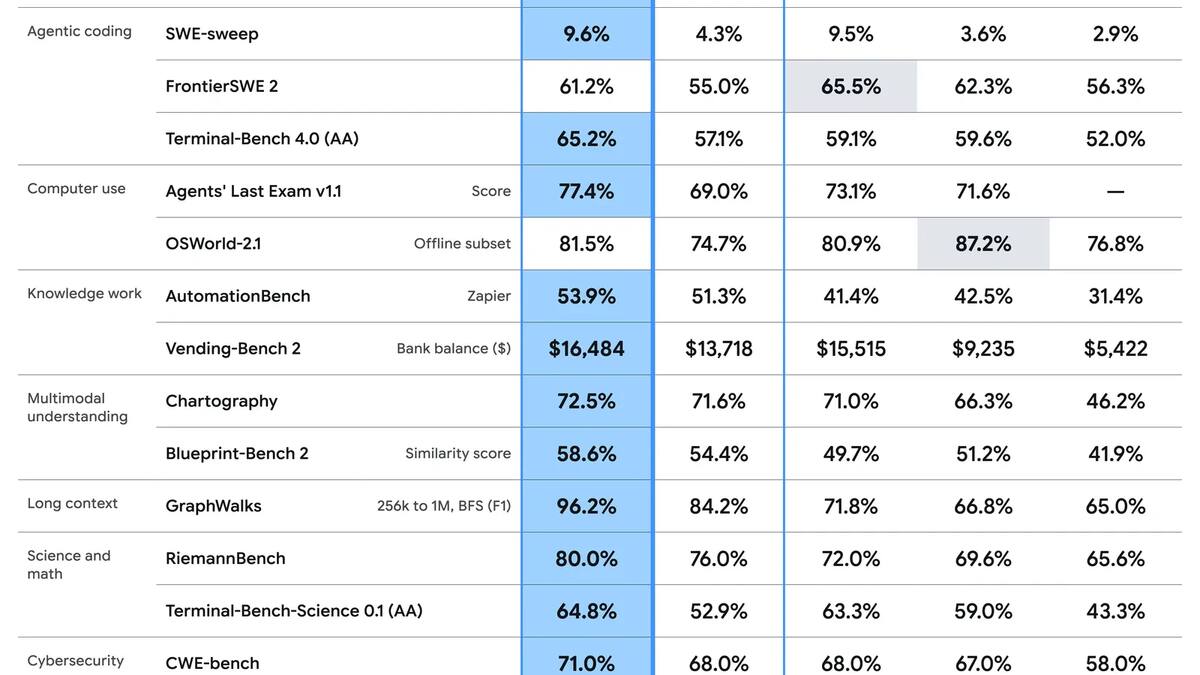
Вместе с анонсом Google опубликовала сводную таблицу оценок, где сравнила Carbon с Argon, GPT-6 Astra, Claude Opus 5.5 и Claude Fable 5.1. Часть результатов получена самой компанией, часть взята из внешних рейтингов и отчётов других лабораторий; методика описана в документе DeepMind. Carbon впереди в 15 строках из 17.
Уступает модель дважды. На FrontierSWE 2 лидирует GPT-6 Astra с 65,5% против 61,2% у Carbon. На офлайн-подмножестве OSWorld-2.1 по управлению компьютером Claude Opus 5.5 набирает 87,2% против 81,5%.
- Terminal-Bench 4.0: 65,2% против 59,6% у Opus 5.5 и 59,1% у Astra;
- GraphWalks (длинный контекст от 256 тысяч до 1 млн токенов): 96,2% против 84,2% у Argon и 71,8% у Astra;
- AutomationBench от Zapier: 53,9% против 42,5% у Opus 5.5;
- Vending-Bench 2, где модель управляет виртуальным бизнесом: итоговый баланс $16 484 против $15 515 у Astra;
- RiemannBench по математике: 80,0% против 72,0% у Astra.
В рейтинге веб-разработки WebDev Arena Carbon прибавила 89 пунктов Эло к Argon и заняла четвёртое место с 1769 пунктами.
Три этапа работы защитника
Работу специалиста по безопасности в Google раскладывают на три шага: найти уязвимость, доказать возможность её эксплуатации и устранить причину. Под каждый этап приводится внешний бенчмарк, все прогоны Carbon выполнены без защитных ограничений.
На SEC-bench Pro, где ищут реальные уязвимости в открытом ПО, модель набрала 88,2%. Далее GPT-6 Astra с 85,4% и Argon с 83,4%.
ExploitGym проверяет, напишет ли модель рабочий эксплойт под заданную уязвимость. При лимите 10 часов на задачу Carbon решила 54,8%, при 6 часах — 53,5%. У Argon за 10 часов 42,0%, у GPT-6 Astra без ограничения по времени 42,4%, у Claude Opus 5.5 за 6 часов 34,5%.
На CWE-bench от Collinear модель должна устранить уязвимость на уровне причины. Carbon в среде Antigravity набрала 71,0%, Grok 4.7, Argon и GPT-6 Astra — по 68,0%, Claude Opus 5.5 в Claude Code — 67,0%.
По внутренним замерам Google, при генерации безопасного кода доля успешных решений у Carbon более чем вдвое выше, чем у Argon. Команда Chrome заявила, что качественные патчи Carbon выдаёт более чем в 10 раз лучше, чем крупная модель другой лаборатории; какую именно, Google не раскрывает. Компания Wiz, по словам Google, видит Carbon лидером в своих бенчмарках по пентесту веб-приложений.
Задачи на несколько дней
Carbon рассчитана на долгие агентные сценарии и многошаговые инженерные задачи. По словам Google, внутренние команды наблюдали, как модель работает над одной задачей несколько дней подряд, выходит из тупиков, находит причины тонких багов в крупных кодовых базах и низкоуровневых системах, а затем исправляет их.
Защиты те же, что у Argon
Набор защитных механизмов у Carbon совпадает с Argon: обучение, фильтры злоупотреблений в реальном времени, устойчивость к промпт-инъекциям и мониторинг цепочки рассуждений. Подробности вынесены в отчёт о безопасности Gemini 4.
- На Terminal-Bench 4.0 доля успешного жульничества с тестами упала до 0,0%, попыток стало 0,4%, точность выросла;
- в живых средах программирования у внутренних команд почти на 80% меньше серьёзных предупреждений о рассогласовании поведения модели;
- необоснованных утверждений примерно вдвое меньше, чем у Argon: вместо выдуманных результатов модель пишет оговорки или перечисляет, чего не хватает;
- превышение полномочий снизилось на 26%, недоработка относительно задачи — на 29%;
- на бенчмарке непрямых промпт-инъекций Gray Swan не прошла ни одна атака, у Argon успешными были 0,7%.
Отзывы до релиза
За неделю до анонса ранние сборки Carbon появлялись у участников программы раннего доступа и на LM Arena. По пересказу TestingCatalog, тестировщики отмечали заметное преимущество над Argon в 3D-задачах, но фронтенд и интерфейсы у модели по-прежнему слабые. Один из тестировщиков оценил задержку ответа в 2–4 раза в зависимости от задачи. Какая именно версия попадала к тестировщикам, неизвестно, поэтому к релизной сборке эти оценки могут не относиться.
Пересчёт в белорусские рубли — по официальному курсу Национального банка на 29.10.2026: $1 = 2,9458 BYN.
Tproger · права на исходный материал принадлежат автору.
Материал носит информационный характер и не является индивидуальной инвестиционной рекомендацией. Операции с криптовалютами связаны с риском полной потери вложенных средств. Подробнее — «Отказ от ответственности».
Разборы событий, итоги дня и то, что двигает рынок. Без сигналов и обещаний — только факты и что они значат.
Читать в Telegram →По теме
- ▪Core 4 Solutions выставила на eBay кластер из 9600 ускорителей NVIDIA A100 за $59 млн3DNews · 28 октября
- ▪Fujifilm вложит 10 млрд иен в пятикратный рост выпуска магнитных лент3DNews · 28 октября
- ▪Anthropic разрешила отключать защиту в Claude Code3DNews · 28 октября
- ▪Математики предупредили об угрозе ИИ для банковской криптографии3DNews · 28 октября