OpenAI перевела монорепозиторий на Git-сервер Pando, задержка push упала почти на 80%
OpenAI перевела весь свой монорепозиторий на собственный серверный бэкенд Git под названием Pando, который принимает push в разные ветки параллельно и отдаёт данные из кеша. По данным компании, медианная задержка push снизилась почти на 80%, а сервис раздаёт почти петабайт Git-данных в сутки. Pando пока недоступен за пределами OpenAI, а сроки и формат возможного открытия технологии компания не назвала.
OpenAI перевела весь свой монорепозиторий на Pando, собственный серверный бэкенд для Git. Сервер принимает push в разные ветки параллельно и раздаёт одни и те же данные тысячам клиентов из кеша. Компания рассказала об этом в инженерном блоге 2 ноября 2026 года. По её данным, медианная задержка push сократилась почти на 80%, то есть почти в 5 раз, а Pando отдаёт почти петабайт Git-данных в сутки. Инженеры и агенты Codex работают с привычными командами Git: протокол и клиент остались прежними, изменился сервер.
Причина в объёме параллельных изменений, который вырос из-за Codex. По словам авторов поста Аарона Фрила, Тейлора Блау и Теда Наймана, у одного инженера теперь одновременно несколько изменений ждут CI, а каждый push запускает несколько задач, которые скачивают один и тот же коммит. С конца 2025 года системы вокруг монорепозитория начали отставать: fetch и push шли медленно, слияния срывались, а надёжность временами падала ниже 90%.
Почему классические схемы не подошли
OpenAI смоделировала два распространённых подхода. В схеме с трёхфазным коммитом каждая реплика хранит полную копию репозитория, а обновление ветки публикуется только после согласия большинства реплик, поэтому каждый push требует нескольких сетевых раундов. Во второй схеме обновления упорядочивает общий журнал в объектном хранилище, но даже push в несвязанные ветки конкурирует за один манифест. В симуляции на 1000 клиентов у первой схемы под нагрузкой растёт задержка записи, у второй задержка чтения. Авторы оговаривают, что это синтетические модели, а не продакшен-бенчмарк.
Как устроен push
Pando отказался от двух вещей, которые обычные Git-серверы считают обязательными: от согласованного снимка всех веток на один момент и от отдельного пакета для каждого клиента. Вместо снимка используется причинная согласованность: обновления одной ветки строго упорядочены, а разные ветки независимы. Клиенты конфликтуют только при одновременном push в одну ссылку. Входящий packfile сервер проверяет за один проход и записывает в объектное хранилище без распаковки, затем одной транзакцией фиксирует «версию ссылки». Клиент сразу видит свою запись, а число операций с метаданными не зависит от размера push.
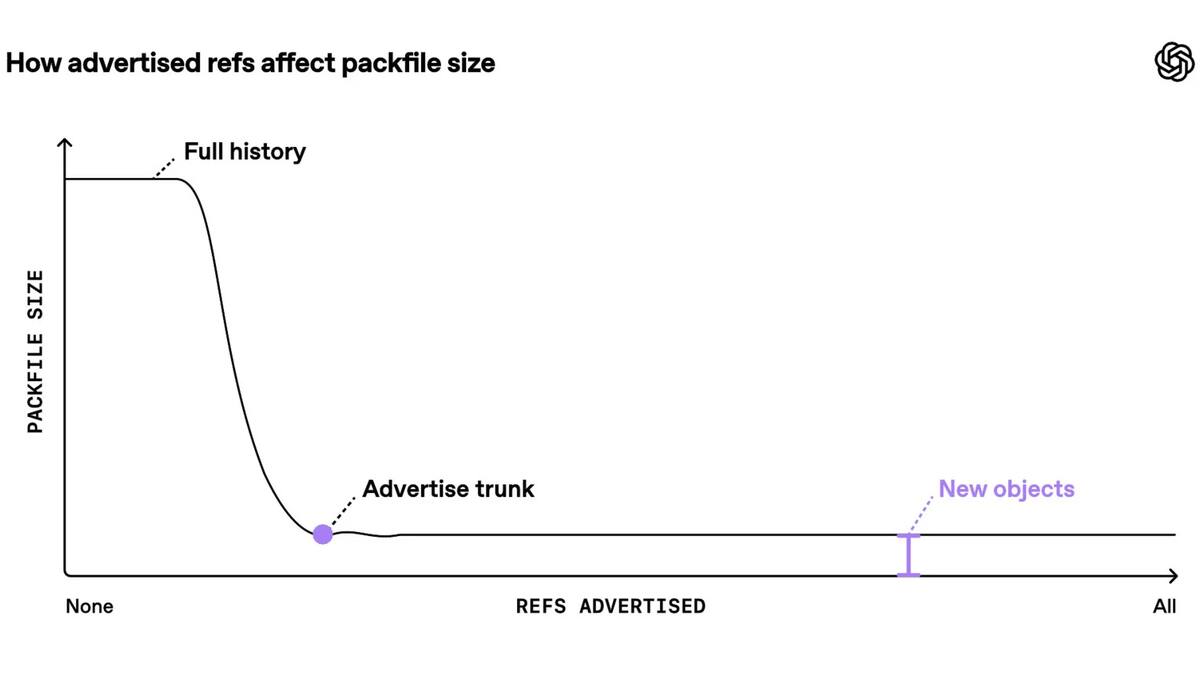
Обычный сервер перед push объявляет клиенту все свои ветки; при миллионах веток такое объявление, по данным OpenAI, может превысить 100 МиБ. Pando объявляет только основную ветку (trunk). Медианный пакет в монорепозитории OpenAI меньше 20 КиБ, 99-й перцентиль меньше 3 МиБ. Цена решения в том, что при повторных push в ветку клиент заново отправляет всё, чего нет в trunk.
Как отдаются данные
При fetch сервер ничего не пересчитывает: по записям, сделанным при push, он выбирает уже лежащие в хранилище пакеты, которые покрывают нужные объекты. Доставку обеспечивает возможность протокола Git packfile-uri: в ответе приходит пустой пакет, а данные клиент забирает через сервис Express с региональными кешами. Запросы распределяются консистентным хешированием, доля попаданий в кеш больше 99%. По данным OpenAI, на стандартных облачных виртуальных машинах clone и fetch полностью загружают каналы 10 Гбит/с. Фоном Pando объединяет мелкие пакеты по схеме, похожей на уплотнение в LSM-деревьях, до уровня L4.
Что вернулось в основной Git
Поскольку пакеты отдаются готовыми, скорость скачивания и индексации стала критичной. OpenAI нашла и исправила пограничные случаи при параллельных загрузках, очистке после прерванной передачи и возобновлении завершённых загрузок, а также добавила трассировку packfile-uri с подсчётом байт. Эти изменения компания отправила в основной проект Git, часть уже принята в upstream. В собственной сборке Git клиент скачивает независимые пакеты параллельно, а механизм «явных haves» позволяет делать push с --force-with-lease, собирая пакет относительно trunk. Ход работы виден в публичном трекере патчей OpenAI.
Как построили за 10 недель
Pando написан на Rust без унаследованных зависимостей. Ядро спроектировал один инженер, реализовали команды агентов Codex, развернули несколько инженеров. Агенты проверяли изменения тестами на соответствие поведению Git, а гонки искали детерминированным симуляционным тестированием. С помощью GPT-6 Astra они написали на Lean и TLA+ формальную «теорию Pando», по которой находили ошибки реализации и доказывали свойства системы. Переезд прошёл без простоя: сначала перед старой системой поставили прокси на чтение и запись, и трафик переводили по частям.
Чем подход отличается от Anthropic
Anthropic в посте от 13 октября 2026 года сообщила, что число слияний в её монорепозитории выросло примерно с 2500 в день в мае до более чем 30 000 в сентябре. Команда из семи человек за пять месяцев построила собственную систему контроля версий Scion и перевела на неё монорепозиторий, без packfile вовсе. По данным Anthropic, инфраструктура стала в 200 раз меньше по CPU и памяти прежних зеркал Git. Сама Anthropic пишет, что Scion не подходит как замена Git для общего использования. OpenAI оставила протокол Git, поэтому её доработки со временем могут попасть в обычный git у любого разработчика.
Что это значит для команд
Pando недоступен вне OpenAI, компания изучает способы поделиться технологией, но сроков нет. Из поста можно вынести три практических вывода. Узкое место агентной разработки часто находится в инфраструктуре вокруг кода: число push, fetch из CI и сред агентов растёт кратно, и трафик clone стоит планировать заранее. Схема Pando рассчитана на trunk-based разработку, и длинные стеки веток друг на друге в ней дороже. Изменения в packfile-uri и загрузке пакетов будут появляться в обычном git постепенно.
Ограничения авторы называют сами. При нескольких ветках клиент не получает их состояние на один момент: при одном clone ветка foo может быть в версии 1, а bar в версии 2. Инструменты, которые сравнивают ветки как единый снимок, на таком сервере нужно проверять. Цифры в посте это собственные замеры OpenAI и результаты её симуляции, независимой проверки нет.
Tproger · права на исходный материал принадлежат автору.
Материал носит информационный характер и не является индивидуальной инвестиционной рекомендацией. Операции с криптовалютами связаны с риском полной потери вложенных средств. Подробнее — «Отказ от ответственности».
Разборы событий, итоги дня и то, что двигает рынок. Без сигналов и обещаний — только факты и что они значат.
Читать в Telegram →По теме
- ▪Goldman Sachs оставил инструменты ИИ-программирования только инженерамiXBT · 4 ноября
- ▪Четыре газеты во главе с NYT подали иски против Brave из-за данных для ИИiXBT · 4 ноября
- ▪OpenAI представила программу снижения нагрузки дата-центров на энергосети в пик3DNews · 3 ноября
- ▪Росстандарт утвердил ГОСТ на дирижабли, он вступит в силу 1 февраля 2027 годаiXBT · 3 ноября