KAIST и DeepAuto.ai связали уроки ИИ-агента с исходными прогонами
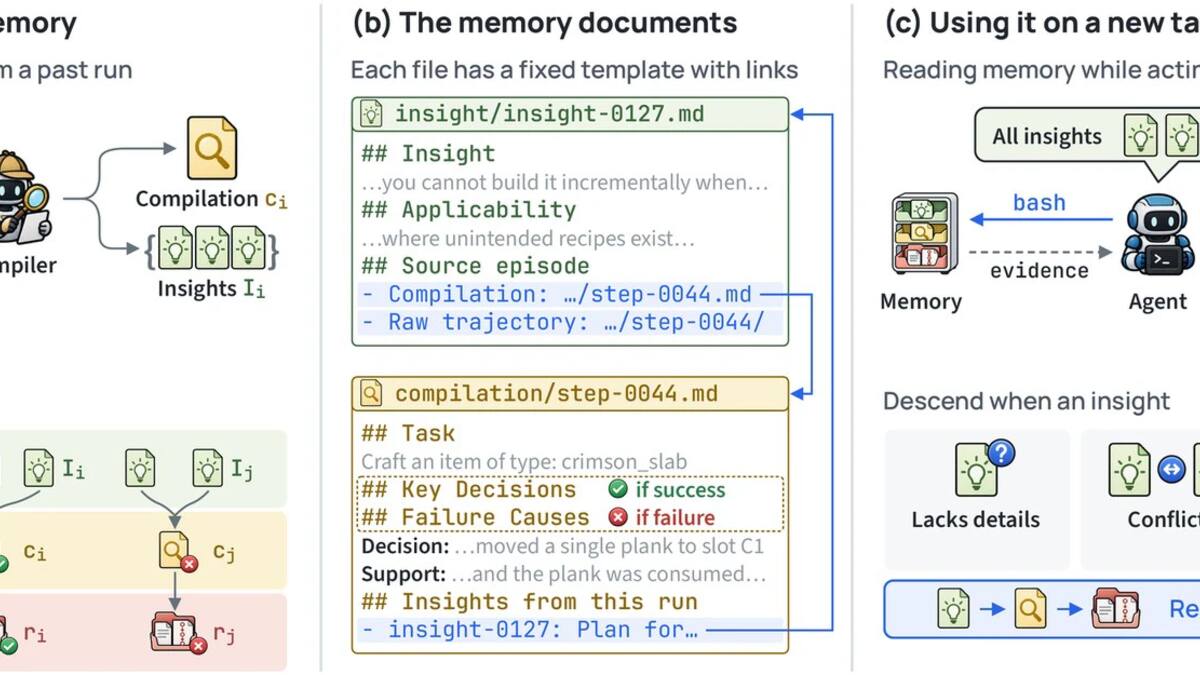
Исследователи KAIST и DeepAuto.ai описали систему памяти WikiTrace: каждый урок агента хранит ссылку на прогон, из которого он выведен, и перед применением урока агент может сверить его с журналом. По замерам авторов, средний результат на пяти бенчмарках составил 90,2 против 79,5 у агента без памяти, но работа ещё не прошла рецензию и не воспроизведена независимо. Тем, кто строит агентов с памятью, это даёт простой повод хранить исходные журналы рядом с выжимками.
10 ноября вышел препринт arXiv:2611.14320 «Don't Just Trust Your Memory». Авторы из корейского института KAIST и компании DeepAuto.ai предлагают систему памяти WikiTrace для ИИ-агентов. Каждый урок, вынесенный из прошлой задачи, хранится вместе со ссылкой на прогон-источник. Перед тем как следовать уроку, агент может открыть этот прогон и проверить, подтверждает ли он урок. Код опубликован на GitHub под лицензией Apache 2.0.
Откуда берётся ошибочный урок
Обычно память агента строят так: модель читает траекторию прошлой задачи, то есть последовательность действий и ответов среды, и сжимает её в короткое правило. Траектория при этом получает одну метку, успех или провал, и она не показывает, какое именно действие привело к исходу. Правило выходит из этой выжимки, и агент получает его уже без журнала. Проверить, верна ли догадка о причине, агенту нечем.
Авторы называют результат этого memory-induced degradation, деградацией из-за памяти. В качестве примера они приводят симулятор домашних дел ALFWorld. Память метода ExpeL содержала правило: задачи с лампой завершаются, когда предмет лежит рядом с включённой лампой. В задаче «рассмотри вазу под настольной лампой» агент с этим правилом включил лампу рядом с вазой и объявил задачу выполненной. Без памяти он брал вазу в руки, включал лампу и задачу решал. Исходный прогон, из которого выведено правило, прямо опровергает его: эпизод завершился только тогда, когда агент взял предмет в руки.
Чтобы оценить масштаб, авторы взяли задачи, которые агент решил во всех трёх прогонах без памяти и провалил с памятью. Пары прогонов они передали LLM-судье gpt-5.6-sol. По его разметке в 52% таких случаев провал был связан с записью из памяти, которой агент последовал. В 20% всех разобранных случаев ошибочной была сама запись. В остальных случаях из этих 52% верное правило применили вне его условий, истолковали слишком широко или предпочли более подходящему. Остальные провалы судья с памятью не связал.
Три слоя памяти WikiTrace
Память устроена как три слоя файлов, связанных ссылками сверху вниз. Нижний слой raw/ хранит прогон целиком: задачу, исход и журнал ходов с рассуждениями, действиями и ответами среды. Средний слой compilation/ содержит разбор прогона, который пишет модель-компилятор: ключевые решения для успешной задачи или вероятные причины провала. Верхний слой insight/ содержит короткие уроки, не больше трёх на прогон. В каждом уроке указано, когда он применим, из какого прогона взят и был ли тот успешным.
Компилятор запускается один раз на прогон и видит только задачу, ходы и признак успеха, эталонного решения у него нет. Уроки не объединяются, не фильтруются и после записи не меняются, поэтому в памяти могут оказаться повторяющиеся или противоречащие друг другу правила. На новой задаче агент получает все уроки в первом сообщении, а также список трёх прошлых прогонов с наиболее похожими задачами. Память смонтирована в песочнице только для чтения, и агент работает с ней обычными командами терминала. Решение о переходе по ссылке к источнику принимает промпт, и авторы называют этот шаг спуском (descent). Спуск разрешён в четырёх случаях: урок говорит, что делать, но не говорит как; урок взят из неудачного прогона; два урока расходятся; действие не удалось. Прогон целиком воспроизводить запрещено, из него берётся только факт, который можно проверить на текущей задаче. Промпт также напоминает модели, что достоверны только сырые ходы.
Результаты на пяти бенчмарках
Агент работал на терминальной оболочке Pi с моделью deepseek-v4-flash на высоком уровне рассуждений, та же модель строила память. Все методы собирали память из одних и тех же прогонов без памяти на обучающих задачах, от 38 до 54 задач на бенчмарк, и проверялись на тестовых наборах из 76–134 задач, по три повтора. Бенчмарков пять: ALFWorld, ScienceWorld и PlanCraft работают с текстовыми командами, AppWorld и tau3-bench Retail используют вызов инструментов. Сравнивали WikiTrace с тремя опубликованными методами: AWM, ExpeL и ReasoningBank. Главный контроль, Insights Only, использует те же уроки без доступа к источникам.
Средний результат по восьми наборам задач выглядит так:
- WikiTrace: 90,2;
- Insights Only, те же уроки без источников: 87,0;
- ReasoningBank: 81,7;
- AWM: 81,6;
- ExpeL: 80,3;
- агент без памяти: 79,5.
WikiTrace оказался лучшим на всех восьми наборах. Insights Only отстал в среднем на 3,2 пункта. Среднее складывается из разных метрик: в ALFWorld и PlanCraft это доля успешных задач, в ScienceWorld средний балл, в AppWorld доля выполненных задач, в tau3-bench Retail доля пройденных. Поэтому 90,2 нельзя читать как 90,2% решённых задач. Разброс между повторами местами велик: на PlanCraft unseen у WikiTrace 81,3 при стандартном отклонении 8,5, у Insights Only 73,0 при 10,7. На tau3-bench Retail все остальные методы с памятью показали результат ниже агента без памяти, WikiTrace такого не допустил ни на одном наборе.
Сколько задач агент начинает проваливать
Средний балл не отделяет случаи, когда память помогла решить новое, от случаев, когда она сломала старое. Поэтому авторы считают два показателя отдельно. Gain — доля успехов на задачах, которые агент без памяти проваливал. Regression — доля провалов на задачах, которые он без памяти решал. Решённой считается задача, которую агент решил в большинстве из трёх прогонов без памяти.
У WikiTrace Regression составил 4,5%, у Insights Only 6,5%. Уровень шума задаёт повторный запуск агента без памяти: он даёт 9,7%, потому что агент недетерминирован. Поэтому сам показатель не доказывает, что конкретный провал вызвала именно память. По словам авторов, Regression у WikiTrace ниже, чем у Insights Only, на семи наборах из восьми. Это единственный метод, чей 95-процентный доверительный интервал целиком лежит ниже полосы повторного запуска. Gain у WikiTrace превышает уровень повторного запуска на 35 процентных пунктов, у Insights Only на 27, у опубликованных методов на 7–14.
Агент обращался к источникам чаще на трудных задачах: в трёх текстовых мирах он открывал разбор или сырой прогон в 22% запусков на лёгких задачах и в 44% на трудных. Когда открытый прогон менял план агента, а это произошло в 43% запусков со спуском, отрыв от Insights Only составил 8,3 пункта. Когда источник лишь подтверждал план или не пригодился, отрыв был 4,4 пункта. Эти доли размечали LLM-судьи, а агент сам решает, спускаться ли, поэтому запуски со спуском и без него различаются не только спуском.
Цена и проверка на другой модели
Решение одной задачи с WikiTrace обходится в среднем в 1,17 раза дороже, чем с Insights Only. Сравнение идёт именно с этим вариантом, потому что с агентом без памяти стоимость не сопоставима. Увеличенный бюджет на построение памяти конкурентам не помог. Когда построитель AWM запустили по тем же траекториям девять раз, а ExpeL и ReasoningBank по три, их средние поднялись до 83,8, 83,3 и 82,8. Всё это осталось ниже 87,0 у Insights Only.
На второй модели, GLM-5.3-flash с уровнем рассуждений medium, эксперимент провели в меньшем объёме: только три набора, оба PlanCraft и ScienceWorld. WikiTrace набрал в среднем 92,7, Insights Only 90,9, агент без памяти 71,2. Каждый из опубликованных методов хотя бы на одном наборе уступил агенту без памяти. Основной результат 90,2 относится только к deepseek-v4-flash.
Что работа не доказывает
Ссылка на источник помогает агенту проверить урок по прогону, но сам урок от этого не становится верным. Авторы пишут об этом в разделе об ограничениях. Память строится по бинарному исходу прогона, поэтому диагноз компилятора и любой урок из него могут быть ошибочными.
- Масштаб. Все уроки попадают в первое сообщение, и промпт растёт вместе с памятью. В примере для ALFWorld из приложения к статье таких уроков 141. Поиск по памяти, которая не помещается в контекст, авторы оставили открытой задачей.
- Разметка. Категории провалов и поводы для спуска определяли LLM-судьи по рассуждениям агента. Эти рассуждения описывают то, что агент написал, а не обязательно то, что привело к исходу. Согласие двух судей по коэффициенту каппа Коэна составило 0,77 для повода к спуску, 0,63 для цели и 0,46 для эффекта.
- Сравнение. Конкурентов запускали по официальным реализациям, но в общем офлайн-протоколе: память строится один раз и замораживается. ReasoningBank поэтому не обновлялся после каждой тестовой задачи, а ExpeL работал без повторных попыток и подбора примеров.
- Охват. Основной эксперимент проведён на одной модели. Среди пяти бенчмарков нет задач на работу с репозиторием кода.
Статья подана на рецензирование в ACL Rolling Review, и выводы могут измениться после него. Независимого воспроизведения результатов пока нет. Готового продукта авторы не выпускали: репозиторий воспроизводит эксперименты статьи. Для повторного запуска нужны Python 3.11 или новее, uv, Node 20, Docker и ключ OpenRouter.
Tproger · права на исходный материал принадлежат автору.
Материал носит информационный характер и не является индивидуальной инвестиционной рекомендацией. Операции с криптовалютами связаны с риском полной потери вложенных средств. Подробнее — «Отказ от ответственности».
Разборы событий, итоги дня и то, что двигает рынок. Без сигналов и обещаний — только факты и что они значат.
Читать в Telegram →По теме
- ▪Китай создал ИИ для слежки за китайцами по всему миру — он находит полезных людей и потенциальных шпионов3DNews · 12 ноября
- ▪Gemini больше не эксклюзив Android Auto: ИИ-помощник Google появился в Apple CarPlayiXBT · 12 ноября
- ▪Anthropic блокирует Claude для российских компаний независимо от местонахождения сотрудниковiXBT · 12 ноября
- ▪Альтман позвал Samsung в союз против Apple — OpenAI задумала гаджет для эпохи «после смартфонов»3DNews · 12 ноября