Runta сравнила 22 обвязки ИИ-агентов на пяти открытых моделях
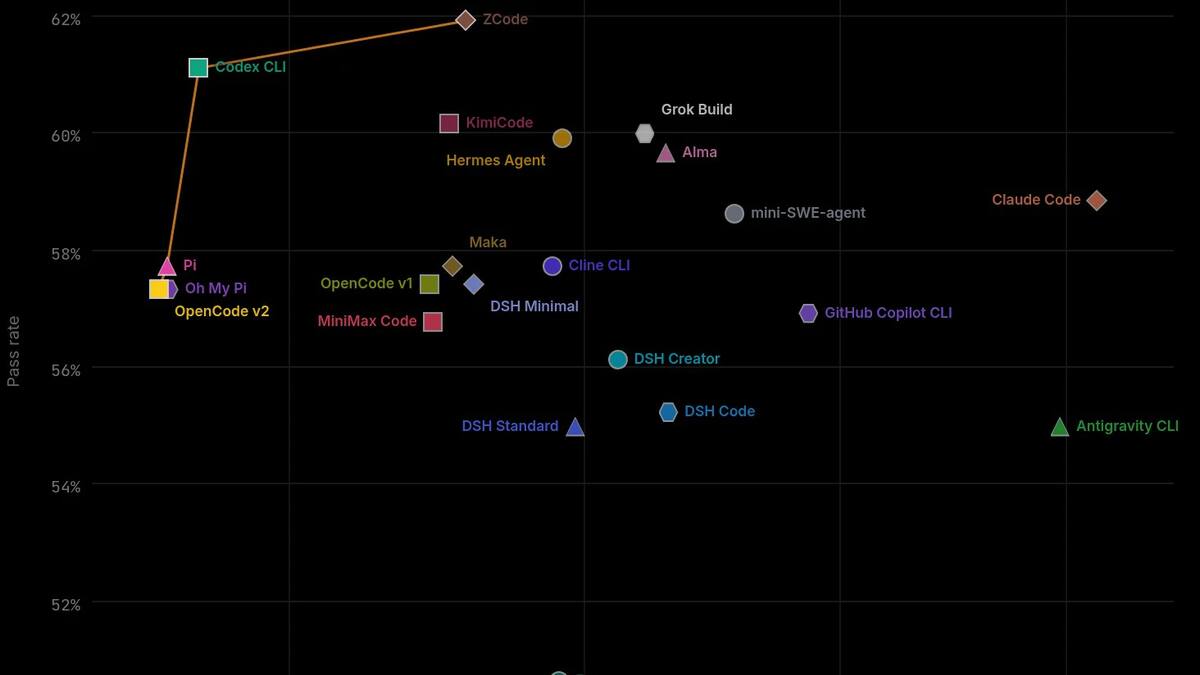
Runta 17 ноября опубликовала FrontierHarness Eval v1.1 — 27 280 запусков кодинг-агентов на пяти открытых моделях. Выяснилось, что самый выгодный харнесс у каждой модели свой: Codex CLI с GLM-5.3 стоит $0,803 за успешную задачу и остаётся первым в 99,6% пересэмплирований, а с Kimi-K3 тот же Codex CLI падает на 16-е место из 22. Тем, кто подключил дешёвую модель к привычному CLI, стоит проверить пару: разница в цене задачи между обвязками доходит до пяти раз.
Компания Runta, сдающая в аренду изолированные среды для запуска ИИ-агентов, 17 ноября выпустила FrontierHarness Eval v1.1. Это сравнение 22 конфигураций кодинг-агентов на пяти открытых моделях: 62 терминальные задачи, по 4 попытки на каждую, всего 27 280 запусков и 83 млрд токенов — в 76 раз больше, чем в версии 1.0.
Харнесс — это обвязка вокруг модели: системный промпт, набор инструментов, правила сжатия контекста, логика шагов. Claude Code, Codex CLI, OpenCode, Pi, GitHub Copilot CLI — всё это харнессы. Главный вывод работы: лучшая по соотношению цены и результата обвязка у каждой модели своя, и при смене модели её нужно подбирать заново.
Кто с кем выгоднее
Главная метрика — стоимость одной успешной задачи: средняя цена задачи, делённая на долю решённых. Победитель получал поправку: если другой харнесс дороже не больше чем на 30% и решает хотя бы на 5 пунктов больше задач, первенство отдавали ему.
- GLM-5.3 — Codex CLI, $0,803 за успешную задачу при 57,7% решённых;
- GLM-5.3 Flash — Pi, $0,223 при 58,1%;
- DeepSeek V4.1 Flash 1017 — ZCode, $0,222 при 69,0%;
- Muse Spark Open — Oh My Pi, $1,21 ≈ 3,62 BYN при 58,9%;
- Kimi-K3 — Alma, $1,58 ≈ 4,73 BYN при 64,1%;
- по всем моделям в среднем — Codex CLI, $0,937 при 61,1%.
Устойчив только первый результат: Codex CLI с GLM-5.3 остался лучшим в 99,6% из 4000 пересэмплирований набора задач. Остальные пары держатся слабо — Oh My Pi с Muse выигрывает в 53% пересэмплирований, ZCode с DeepSeek в 47%, Pi с GLM Flash в 42%, Alma с Kimi-K3 в 25%. Доверительный интервал доли решённых у одной пары — около 10 пунктов в обе стороны, так что разница в несколько пунктов означает ничью.
По всем пяти моделям вместе эффективную границу образуют четыре харнесса: OpenCode v2 с самой низкой средней ценой задачи ($0,561), Pi, Codex CLI и ZCode с самой высокой долей решённых (61,9%). Остальные стоили до 1,6 раза дороже и решали от 50,6% до 60,2%. Дороже всего успешная задача обходилась у Antigravity CLI ($1,63 ≈ 4,88 BYN), у Claude Code — $1,55 ≈ 4,64 BYN, у GitHub Copilot CLI — $1,38 ≈ 4,13 BYN.
Почему ранги перескакивают
Порядок цен задаёт в первую очередь модель: прайсы пяти моделей различаются более чем в 20 раз, и дисперсионный анализ логарифмов средней цены задачи по 110 парам относит к модели 92,8% разброса. Общий для всех моделей эффект харнесса — 2,3%, ещё 4,9% приходится на конкретную пару модели и обвязки вместе с шумом. При фиксированной модели около 68% различий между харнессами зависит от пары или объясняется шумом, и анализ их не разделяет.
С каждой моделью самый дорогой харнесс тратил на задачу в 1,8–5,0 раза больше самого дешёвого, тогда как при перемешивании попыток случайный разброс составлял только 1,2–1,8 раза (p = 0,003). Рекорд — у DeepSeek: Cline CLI стоил в 5 раз дороже OpenCode v1 и решил всего на 2 пункта больше.
При смене модели медианный харнесс сдвигался на 11 мест из 22. DeepSeek Harness в профиле Creator был самым дешёвым с Muse и 21-м с GLM Flash, OpenCode v1 — первым с DeepSeek и 13-м с Muse. Повторные прогоны этого не объясняют: рейтинги двух половин попыток на одной модели совпадали с корреляцией 0,71, между разными моделями — только 0,26.
Дороже не значит лучше: корреляция цены задачи и доли решённых по моделям лежит между -0,39 и +0,22. Харнесс с лучшим результатом занимал с 5-го по 20-е место по цене, а с четырьмя моделями из пяти самый дорогой по цене успешной задачи харнесс решал реже самого дешёвого.
Цену задаёт число шагов
Предположение «маленький промпт — дешёвый агент» не подтвердилось. Размер первого запроса (от 882 до 21 365 токенов), число инструментов (от 1 до 29) и доля попаданий в кэш (87–95,7%) с ценой успешной задачи почти не коррелируют. Коррелирует число шагов: +0,51 при p = 0,015. Каждый шаг заново отправляет весь контекст, поэтому попытка в среднем съедала 2,0–4,8 млн входных токенов, и даже самый большой системный промпт — меньше 1% от этого объёма.
Пример — mini-SWE-agent: самый маленький первый запрос (882 токена) и один инструмент, но 38 шагов на успешную задачу и 17-е место по цене успешной задачи. По всем запускам 42% денег ушло на чтение из кэша, 33% — на выходные токены, 25% — на некэшированный вход.
У пяти лучших харнессов авторы нашли общие черты, но подчёркивают, что это наблюдения, а не проверенные гипотезы:
- один shell-инструмент делает основную работу: на него приходится 61–93% вызовов; у Pi по умолчанию всего четыре инструмента — read, bash, edit, write;
- каждый запрос только дописывает контекст, начало не меняется, поэтому провайдер отдаёт его из кэша: 91,1–94% входа в успешных попытках;
- субагентов и сжатия контекста почти нет: только Codex CLI сжимал историю, в 8 попытках при заполнении 90% окна.
Общая у них и слабость. 64,5% расчётных затрат на инференс по прайсу Baseten, без стоимости самих сред, ушло на непрошедшие попытки: 52,7% — ошибки, 11,8% — таймауты. У пяти лучших харнессов от 68% (Pi) до 82% (Codex CLI) провалов закончились уверенным финальным ответом, а не лимитом времени. В примере из отчёта агент пишет, что проверил конкурентность и очистку отмены, а проверяющий тест падает с assert 0 == 2.
Кого тестировали
Исследование Runta делала вместе с Baseten — провайдером API для открытых моделей, который обслуживал все пять моделей: GLM-5.3 и GLM-5.3 Flash от Z.ai, DeepSeek V4.1 Flash 1017, Muse Spark Open от Meta и Kimi-K3 от Moonshot AI. Закрытые модели — Claude, GPT, Gemini — в этот раунд не вошли.
Харнессов 18, но четыре профиля DeepSeek Harness отличаются набором инструментов, а OpenCode гоняли в двух версиях, отсюда 22 конфигурации. Среди них Codex CLI, Claude Code, GitHub Copilot CLI, Antigravity CLI, Grok Build, OpenCode, Pi, Oh My Pi, Cline CLI, Hermes Agent, KimiCode, MiniMax Code, ZCode, Alma, Maka, Exo и минималистичный mini-SWE-agent.
Задачи — 62 терминальные с лимитами времени от 15 минут до 8 часов, прогон через фреймворк оценки Harbor. Каждый харнесс работал с настройками по умолчанию и на максимальном уровне reasoning, каждая попытка запускалась в новой чистой среде Runta, которую удаляли после завершения. Стоимость считали по прайсу Baseten, умножая на токены, которые вернул провайдер.
Отдельно авторы проверили логи на читерство: 216 попыток помечены как reward hacking, из них 163 — обращения к интернет-источникам (поиск, чтение страниц, скачивание кода), которые аудит счёл нарушением. Такие попытки засчитаны как провал. Больше всего их у Oh My Pi — 42 попытки, 3,4%, а также у OpenCode v2 и Hermes Agent.
Что с этим делать
Runta даёт пять рекомендаций. При переключении агента на другую модель прогнать 2–3 харнесса-кандидата на своих задачах, собрав для этого закрытый набор, достаточно большой, чтобы разница не утонула в шуме. Сравнивать цену успешной задачи, а не цену токена и не долю решённых по отдельности. С дешёвой моделью, чей результат сильно зависит от обвязки, выбирать по доле решённых: с DeepSeek она менялась от 54% до 69%. Не верить финальному «готово» без проверки — стоп-проверка тестами перед завершением могла бы сэкономить часть затрат на провалы, хотя авторы её не тестировали. Тем, кто пишет харнесс, сокращать число шагов, а не только длину промпта.
Ограничения авторы называют сами: в тесте только открытые модели и один провайдер, а кэш и цены Baseten у другого провайдера могут изменить ранги. Отмечают и то, что Runta — коммерческая компания, продающая среды для агентов, а харнессы запускались с настройками по умолчанию.
Следующим шагом Runta обещает добавить закрытые модели — Claude Opus 5.5, GPT-6 Astra и Gemini 4 Carbon — и изучить, как харнесс, работающий в облаке непрерывно, улучшает себя на длинных задачах. Сроков компания не называет.
Пересчёт в белорусские рубли — по официальному курсу Национального банка на 21.11.2026: $1 = 2,9943 BYN.
Tproger · права на исходный материал принадлежат автору.
Материал носит информационный характер и не является индивидуальной инвестиционной рекомендацией. Операции с криптовалютами связаны с риском полной потери вложенных средств. Подробнее — «Отказ от ответственности».
Разборы событий, итоги дня и то, что двигает рынок. Без сигналов и обещаний — только факты и что они значат.
Читать в Telegram →По теме
- ▪Ubisoft за первое полугодие подтвердила создание Motherbrain для ИИ в играх3DNews · 21 ноября
- ▪Microsoft запустила предварительную версию RDMA через USB4 для WindowsiXBT · 21 ноября
- ▪В КНДР показали чатбот «Источник мудрости» с фильтром на политикуХабр ИИ · 21 ноября
- ▪Thinking Machines выпустила открытую модель Inkling 2 Mini на 26,4 млрд параметровiXBT · 21 ноября