Artificial Analysis перевела Intelligence Index на v5: 60% веса приходится на закрытые тесты
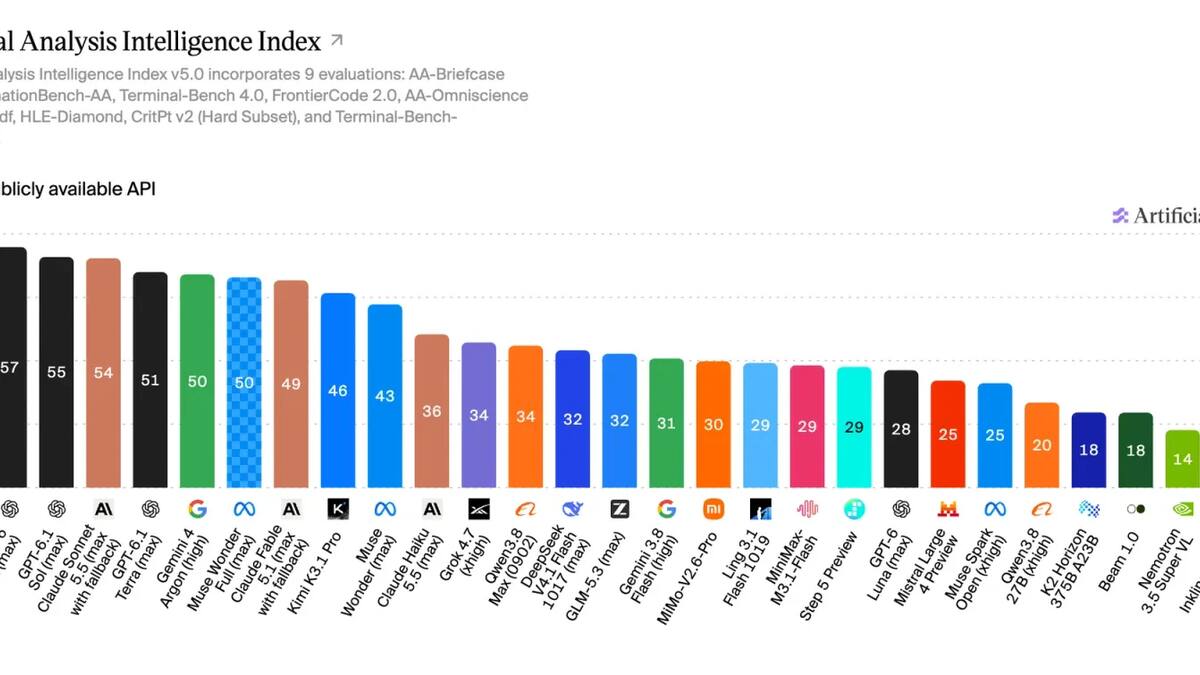
27 октября 2026 года Artificial Analysis выпустила пятую версию сводного рейтинга моделей Intelligence Index: два теста добавлены, три обновлены, три убраны, а 60% итогового балла теперь считается по задачам, которых нет в открытом доступе. Через день после запуска на первое место с 59 баллами вышла Gemini 4 Carbon, сместив Claude Opus 5.5 с 58 баллами. Разрыв между закрытыми и открытыми моделями вырос с 3 до 12 баллов, а стоимость решения одной задачи у десяти лидеров различается более чем в 13 раз — от $0,96 до $13,04 ≈ 38,41 BYN.
27 октября 2026 года Artificial Analysis представила Intelligence Index v5 — сводный рейтинг, по которому разработчики сравнивают возможности языковых моделей. Предыдущая версия, v4, вышла в январе, и нынешнее обновление стало самым крупным с тех пор.
Ключевое отличие в том, что 60% итогового балла теперь набирается на тестах с закрытыми наборами задач или скрытыми ответами. Задач нет в открытом доступе, поэтому они не попадают в обучающие данные моделей, и «выучить» их сложнее.
Что добавили, обновили и убрали
Новых тестов два. FrontierCode 2.0 от Cognition, разработчика агента Devin, — это 132 задачи в реальных открытых репозиториях. Результат засчитывают, только если мейнтейнер принял бы изменение агента: провал любой блокирующей проверки обнуляет задачу, а сами задачи закрыты, чтобы модели их не видели при обучении. Terminal-Bench-Science состоит из 70 научно-исследовательских задач, которые агент выполняет в терминале; задача проходит, только если пройдены все её тесты.
Обновили три теста: HLE-Diamond заменил Humanity's Last Exam — это очищенная версия из 1000 вопросов, поровну на рассуждения и на знания; в AA-Omniscience v1.1 убрали вопросы, которые модели уже решают почти все, и вопросы из открытого набора, добавили новые и исправили неоднозначные; CritPt v2 считается по закрытому подмножеству из 40 сложных задач по физике, которые модели решают с инструментом для выполнения кода.
AA-Briefcase, AutomationBench-AA, GDP.pdf и Terminal-Bench 4.0 остались в индексе. Убрали GDPval-AA v2.1, SciCode и AA-LCR v1.1.
- AA-Briefcase — 15%
- AutomationBench-AA — 5%
- GDP.pdf — 5%
- FrontierCode 2.0 — 15%
- Terminal-Bench 4.0 — 10%
- Terminal-Bench-Science — 15%
- CritPt v2, сложное подмножество — 10%
- AA-Omniscience v1.1 (10% точность, 5% отсутствие галлюцинаций) — 15%
- HLE-Diamond — 10%
Лидерство держалось сутки
В день запуска первой была Claude Opus 5.5 в режиме max с 58 баллами, за ней шли GPT-6 Astra с 57 и GPT-6.1 Sol с 55. Первые пять мест заняли модели Anthropic и OpenAI, Gemini 4 Argon оказалась следующей с 50 баллами.
28 октября Google анонсировала Gemini 4 Carbon, и Artificial Analysis поставила её на первое место с 59 баллами. На Artificial Analysis Coding Agent Index новая модель уступает только Opus 5.5. Цена заявлена на уровне $4 ≈ 11,78 BYN и $20 ≈ 58,92 BYN, но пока Carbon доступна только ограниченной группе специалистов по кибербезопасности.
Ни одна модель не лидирует во всех девяти тестах. Claude Opus 5.5 первая в трёх: FrontierCode 2.0 (46%), HLE-Diamond (68%) и AA-Omniscience v1.1 (48 баллов). GPT-6 Astra выигрывает Terminal-Bench-Science (63%) и CritPt v2 (72%). Claude Sonnet 5.5 — в AA-Briefcase (1812 пунктов Эло), Kimi K3.1 Pro — в Terminal-Bench 4.0 (67%), Gemini 4 Argon — в AutomationBench-AA (78%), Muse Wonder Full — в GDP.pdf (33% задач решены полностью).
На FrontierCode 2.0 следом за Claude Opus 5.5 с 46% идут GPT-6 Astra, GPT-6.1 Terra и Claude Sonnet 5.5, у всех по 42%. Лучшая открытая модель в этом тесте, DeepSeek V4.1 Flash 1017, набрала 28%.
В HLE-Diamond вопросы на знания оказались для лидеров тяжелее вопросов на рассуждения: Claude Opus 5.5 и GPT-6 Astra берут по 78% на рассуждениях и только 58% и 50% на знаниях.
Открытые веса отстали на 12 баллов
Лучшая модель с открытыми весами, Kimi K3.1 Pro, набрала 46 баллов, но её веса ещё не опубликованы. Отставание от лидера выросло до 12 баллов — в v4.3 оно составляло 3. Среди моделей, чьи веса уже можно скачать, первые DeepSeek V4.1 Flash 1017 и GLM-5.3 с 32 баллами, это ниже Claude Haiku 5.5 с её 36.
Сильнее всего разрыв виден на HLE-Diamond и Terminal-Bench-Science: у Kimi K3.1 Pro там 37% и 34% против 68% у Claude Opus 5.5 и 63% у GPT-6 Astra.
Задача стоит от $0,96 до $13,04 ≈ 38,41 BYN
Стоимость решения одной задачи индекса среди десяти лидеров различается более чем в 13 раз: от $0,96 у GPT-6.1 Terra до $13,04 у Claude Fable 5.1. Claude Opus 5.5 обходится в $10,04 ≈ 29,58 BYN за задачу, GPT-6 Astra — в $6,24 ≈ 18,38 BYN, GPT-6.1 Sol — в $1,27 ≈ 3,74 BYN. Sol отстаёт от Opus 5.5 на 3 балла и стоит примерно в восемь раз дешевле.
В v5 сильнее сказывается уровень усилий рассуждения. Claude Opus 5.5 на низком уровне набирает 35 баллов при $0,98 за задачу, на максимальном — 58 при $10,04. У Claude Sonnet 5.5 разница между низким и максимальным уровнем выросла с 20 до 29 баллов, у GPT-6.1 Sol удвоилась с 10 до 20.
Задачи стали объёмнее: медианный расход выходных токенов на задачу вырос с 35 до 59 тысяч. Тесты Terminal-Bench-Science, Terminal-Bench 4.0, AA-Briefcase и FrontierCode 2.0 дают 55% веса индекса и около 90% выходных токенов, примерно треть приходится на один Terminal-Bench-Science.
Gemini 4 Carbon, появившаяся в рейтинге на следующий день, потратила на весь индекс 200 млн выходных токенов при медиане 64 млн, а её задача обошлась в $7,76 ≈ 22,86 BYN.
Отдельная шкала для поколений
Вместе с v5 Artificial Analysis запустила Progress Index v1. Он ставит на одну шкалу языковые модели, выходившие с ноября 2022 года, и показывает рост возможностей во времени, в том числе между моделями с разницей в несколько лет. При проектировании компания опиралась на Epoch Capabilities Index от Epoch AI. Для выбора модели под текущие задачи Artificial Analysis советует смотреть Intelligence Index, а не Progress Index.
Методика Intelligence Index опубликована на сайте Artificial Analysis.
Пересчёт в белорусские рубли — по официальному курсу Национального банка на 29.10.2026: $1 = 2,9458 BYN.
Tproger · права на исходный материал принадлежат автору.
Материал носит информационный характер и не является индивидуальной инвестиционной рекомендацией. Операции с криптовалютами связаны с риском полной потери вложенных средств. Подробнее — «Отказ от ответственности».
Разборы событий, итоги дня и то, что двигает рынок. Без сигналов и обещаний — только факты и что они значат.
Читать в Telegram →По теме
- ▪Anthropic сообщила, что её модель нашла уязвимости в Chrome, Safari, Android, Windows и Linux3DNews · 28 октября
- ▪Core 4 Solutions выставила на eBay кластер из 9600 ускорителей NVIDIA A100 за $60 млн3DNews · 28 октября
- ▪Google открыла Gemini 4 Carbon только специалистам по киберзащитеTproger · 28 октября
- ▪Fujifilm вложит 10 млрд иен в пятикратный рост выпуска магнитных лент3DNews · 28 октября